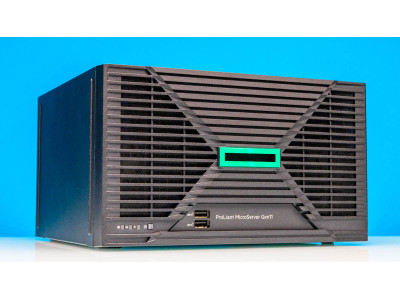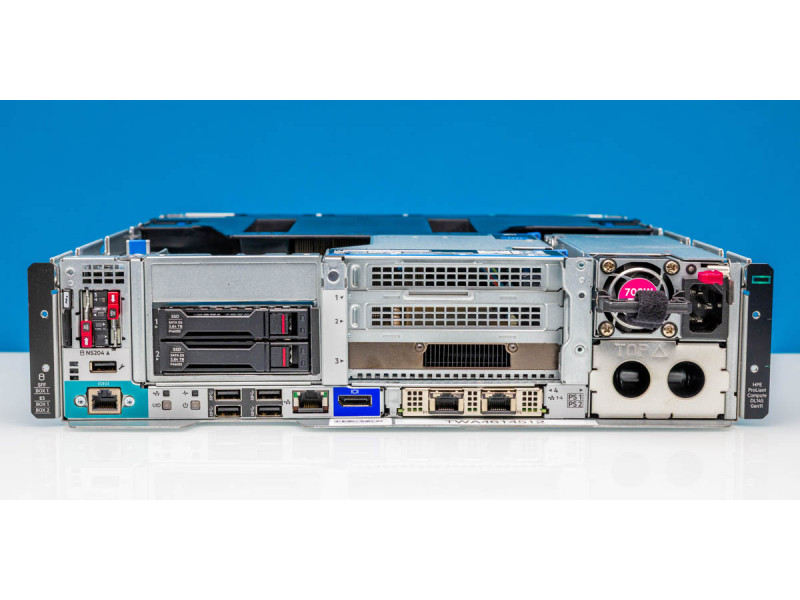
Коротко. Связка DL145 Gen11 с ускорителем NVIDIA — это узел для инференса на площадке, а не для обучения моделей. Разница принципиальная: обучение требует десятков киловатт и кластера, инференс — одной карты и пары сотен ватт. Типовой сценарий в Узбекистане — видеоаналитика на объекте: распознавание номеров, подсчёт людей, контроль спецодежды, когда гонять видеопоток в центр дороже, чем обработать его на месте. Модели в каталоге ITsmart нет; расчёт узла под конкретную задачу делаем по запросу.
Сервер для видеонаблюдения: расчёт и цены → — объём архива, число камер, готовые комплекты.
Быстрый переход: инференс против обучения · какая карта нужна · сколько видеопамяти · питание и охлаждение · когда это окупается · вопросы и ответы
Инференс против обучения — это разные машины
Путаница здесь стоит дорого. Обучение модели — это недели работы кластера из карт по 300–700 Вт каждая, с быстрой связью между узлами и отдельным контуром охлаждения. Инференс — применение уже обученной модели к потоку данных: одна карта, десятки или пара сотен ватт, обычный сервер.
Девяносто процентов задач бизнеса — инференс. Модель берётся готовой или дообучается один раз в облаке, а дальше годами работает на площадке. Именно под этот сценарий и сделаны периферийные узлы с одним ускорителем.
Какая карта нужна
Для периферии важны не пиковые числа, а теплопакет и форм-фактор.
- Карты на 70–75 Вт с пассивным охлаждением и половинной длиной — основной выбор для edge. Питаются от слота, не требуют дополнительных кабелей, помещаются в короткий корпус.
- Карты на 150–300 Вт дают больше потоков на узел, но требуют полноразмерного корпуса, усиленных вентиляторов и блоков питания большей мощности. В неглубоком шкафу это чаще всего нереализуемо.
- Карты на 400 Вт и выше — это уже про центр обработки данных, а не про площадку.
Перед выбором посчитайте не «сколько карт влезет», а сколько потоков камер нужно обрабатывать и с какой частотой кадров. Для задач вроде подсчёта людей хватает 2–5 кадров в секунду, и одна карта тянет десятки потоков; для распознавания номеров на скорости нужно больше.
Сколько видеопамяти
Объём видеопамяти — первое ограничение, в которое упираются на практике. Модель должна помещаться в память целиком вместе с буферами обработки; если не помещается, начинается обмен с системной памятью, и производительность падает в разы.
Ориентир: небольшие модели детекции и классификации укладываются в несколько гигабайт, модели распознавания и сегментации — заметно больше, языковые модели на площадке требуют десятков гигабайт и на периферийной карте обычно не запускаются. Решение о карте принимается по конкретной модели, а не по общим соображениям.
Питание и охлаждение
Ускоритель меняет тепловой баланс шкафа. Практика такая:
- Считайте бюджет шкафа целиком: сервер, ускоритель, коммутатор, ИБП. Карта на 75 Вт добавляет к серверу примерно столько же в пике, карта на 300 Вт — меняет класс всей инсталляции.
- Пассивные карты охлаждаются потоком от вентиляторов сервера. Это значит, что комплект вентиляторов должен быть рассчитан на карту, а не на пустой слот, — отдельная позиция в конфигурации.
- ИБП подбирается по пиковому потреблению с ускорителем под нагрузкой, а не по паспортной мощности блоков питания.
Когда это окупается
Считать нужно не производительность, а стоимость альтернативы. Локальный инференс выигрывает, когда:
- канал до центра узкий или дорогой, а поток видео постоянный;
- решение должно приниматься за доли секунды — шлагбаум, турникет, сигнализация;
- данные нельзя выпускать за периметр площадки по требованиям заказчика.
Если ни одно из условий не выполняется, дешевле отправлять кадры в центр и держать один мощный узел на всю организацию, а на площадке оставить обычный сервер без ускорителя — например DL320 Gen11 за 41 000 000 сум или DL380 Gen11 за 49 000 000 сум, если нужен запас по слотам.
Посчитаем узел под вашу модель и число потоков — с картой, питанием, охлаждением и хранением. Напишите нам.
Вопросы и ответы
Чем инференс отличается от обучения модели?
Обучение создаёт модель и требует кластера ускорителей, недель времени и десятков киловатт. Инференс применяет готовую модель к потоку данных и обходится одной картой и парой сотен ватт. На периферийной площадке делают именно инференс.
Какая видеокарта нужна для видеоаналитики на объекте?
Для edge обычно берут пассивную карту на 70–75 Вт половинной длины: она питается от слота, не требует дополнительных кабелей и помещается в короткий корпус. Более мощные карты требуют полноразмерного сервера, усиленного охлаждения и другого ИБП.
Сколько видеопамяти нужно?
Модель должна целиком помещаться в видеопамять вместе с буферами. Небольшие модели детекции укладываются в несколько гигабайт, распознавание и сегментация требуют заметно больше. Считать надо по конкретной модели, которую планируется запускать.
Можно ли обучать модели на таком сервере?
Технически да, практически — нет смысла: обучение на одной периферийной карте займёт недели там, где кластер справится за часы. Обучают в облаке или в ЦОД, а на площадку выносят готовую модель.
Сколько камер потянет один узел?
Зависит от модели и от требуемой частоты кадров. Для подсчёта людей и детекции событий при 2–5 кадрах в секунду одна карта обрабатывает десятки потоков; для распознавания номеров на скорости — единицы. Расчёт делается под задачу.